Опыт разработки приложения с трейлерами
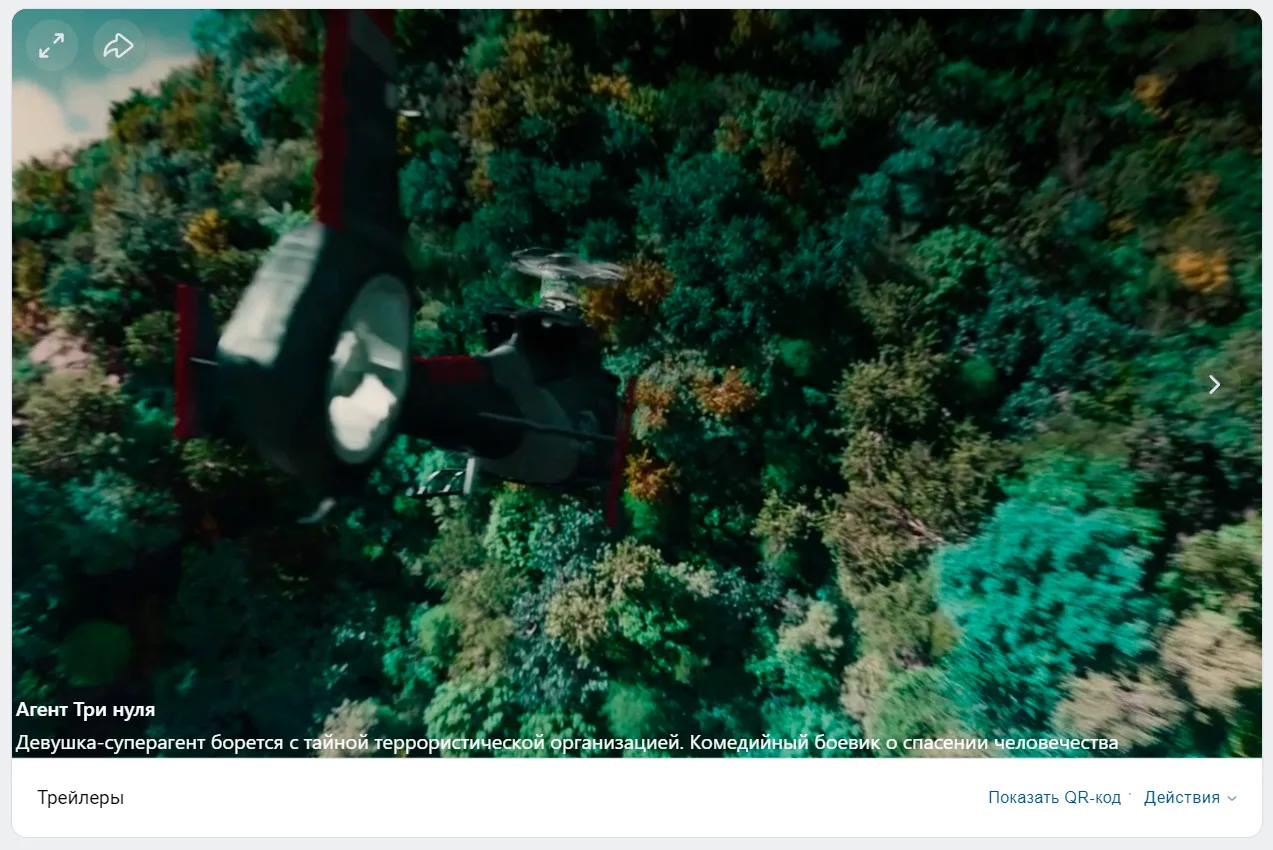
Провал приложения для выбора фильмов по бесконечной ленте с трейлерами
Я давно хотел сделать приложение, которое бесконечно, как в TikTok, показывает трейлеры. Пользователи смотрят их, выбирают фильм на вечер или просто залипают в ленте. В идеале для такого проекта нужна большая база фильмов с трейлерами — хотя бы название, описание и сам трейлер, который должен храниться на CDN. В один момент я твёрдо решил проверить, насколько это сложно, и нашёл один фиолетовый кинотеатр, где внутреннее API было открыто. То ли они неправильно настроили заголовки, то ли просто не запаривались, но к их API могли обращаться любые пользователи напрямую без проверки, откуда был сделан запрос.
Я написал им на почту, спросив, могу ли я сделать приложение с трейлерами на платформе VK Mini Apps. Ответа не было.
Окей, раз API открыто — буду делать и посмотрим, что из этого получится. Фронтенд написал на React с библиотекой VKUI — стандартный набор компонентов для VK Mini Apps. Бекенд — на чистом PHP без фреймворков. Если у вас 1-2 эндпоинта, фреймворк и не нужен, достаточно правильно построить архитектуру.
В их API можно было получать разные подборки, ответ возвращался в JSON. Я парсил все подборки, сохранял себе в базу название фильма, описание и внутренний ID, чтобы потом можно было давать ссылку на их кинотеатр. Набралось аж 10 000 трейлеров — этого уже хватило, чтобы сделать рекомендательную систему.
Когда я делал это приложение, нейросети ещё не были так сильно популярны, поэтому я пошёл по классическому пути — коллаборативная фильтрация. Это алгоритм, который работает на основе поведения других пользователей.
Как это устроено:
1. Вы смотрите трейлер хотя бы на 40%. Система запоминает: «этому пользователю понравился фильм X».
2. Алгоритм ищет других людей, которым тоже понравился фильм X.
3. Затем он смотрит, какие ещё фильмы нравятся этим людям.
4. И рекомендует вам то, что вы ещё не видели, но что смотрели люди со схожими вкусами.
Всё это работает на чистом SQL. Никаких нейросетей, никаких эмбеддингов — просто несколько хитрых запросов к базе.
Выглядит это так:
1. Берём 20 последних фильмов, которые вы досмотрели до установленной константы.
2. Находим других пользователей, которым тоже понравились эти фильмы.
3. Смотрим, что ещё нравится этим пользователям.
4. Отдаём вам топ-10 подходящих вариантов.
Если рекомендаций набирается меньше десяти — алгоритм добивает оставшиеся места случайными фильмами, которые вы ещё не смотрели. Так вы никогда не останетесь без контента. И это отлично работало.
Всего приложением попользовалось около 5000 человек, и с каждым новым десятком пользователей их досмотры росли — некоторые просматривали в приложении по 100 целых роликов. Но в какой-то момент ребята из фиолетового кинотеатра настроили правильно заголовки, и API перестало отвечать на запросы с чужих доменов. Я решил не переделывать и не обходить это.
Ещё было много прикольных решений на фронтенде: ленивая загрузка роликов, обрезка в разных положениях телефона, возможность перейти на сайт и посмотреть фильм, репосты. Но текст уже получается слишком большим, вряд ли кто-то дочитает его до конца :)